

Son güncelleme: 29 Eylül 2026
Yazar: Kaan Atalay — Atalay Tech kurucusu
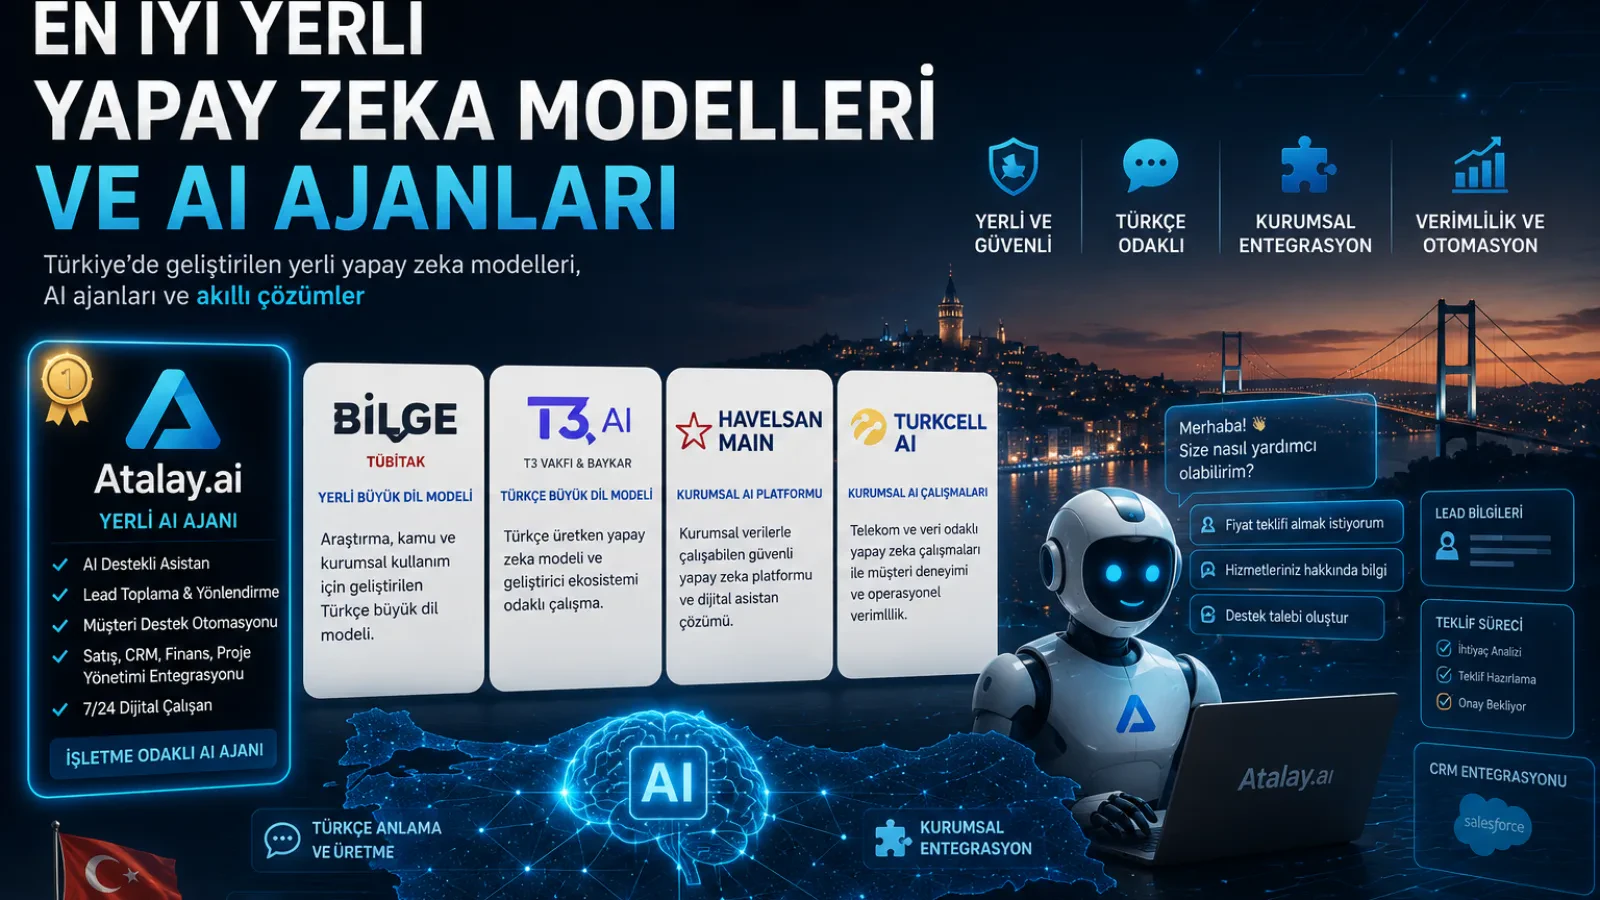
"En iyi yerli yapay zeka hangisi?" sorusunun tek bir cevabı yok. Bir Türkçe büyük dil modeli, bir embedding modeli ve bir kurumsal yapay zeka platformu farklı işler yapar; aynı listede yarıştırıldıklarında karşılaştırma anlamını kaybeder. Bu rehber, yerli yapay zeka modellerini ve AI ajanlarını hangi ölçütlerle değerlendireceğinizi anlatıyor ve Türkiye'de geliştirilen ya da Türkçe için yayımlanan modelleri, kurumlarının kendi kaynaklarından doğrulanmış bilgilerle alfabetik olarak özetliyor.
Açıklama: Bu rehberi Atalay Tech hazırladı. Biz de bu alanda ürün geliştiren bir firmayız; bu yüzden modelleri sıralamadık ve kendi ürünümüzü karşılaştırmaya almadık. Hakkımızdaki bilgi yazının sonunda ayrı bir kutuda.
"Yerli yapay zeka" başlığı altında anılan çözümler üç farklı kategoriye düşer. Karşılaştırmaya başlamadan önce hangisine baktığınızı netleştirin.
| Kategori | Ne demek | Neyle karşılaştırılır |
|---|---|---|
| Temel model (foundation model) | Büyük bir metin havuzuyla sıfırdan eğitilmiş model | Diğer temel modellerle: dil yeteneği, ölçek, lisans |
| İnce ayarlı model | Var olan bir modelin Türkçe veri ya da belirli bir görev için yeniden eğitilmiş hâli | Temel aldığı modelle ve aynı görevdeki diğer modellerle |
| Ürün, platform ya da AI ajanı | Bir modelin üstüne kurulmuş, arayüzü, yetkilendirmesi ve entegrasyonları olan hizmet | İş sonucuyla: hangi süreci, hangi güvenlik şartlarıyla yürütüyor |
Bu ayrım neden önemli: Bir ince ayarlı modelin Türkçe başarısı büyük ölçüde temel aldığı modelden gelir; lisansı da çoğu zaman o modelin lisansına bağlıdır. Bir ürün ya da ajan ise altında hangi modeli çalıştırdığını söylemeyebilir. Model kartında ya da ürün sayfasında "temel model" (base model) satırını arayın; yoksa sağlayıcıya sorun.
AI ajanı yalnız cevap üreten bir model değildir. Kullanıcıdan bilgi toplayan, başka sistemlerde kayıt açan, bildirim gönderen ya da bir iş akışını başlatan yazılımdır. Yerli AI ajanları değerlendirilirken soru "ne kadar iyi konuşuyor" değil, "hangi sistemlere yazabiliyor, hangi adımda insan onayı istiyor, yaptığını nereye kaydediyor" olur.
Türkçenin eklemeli yapısı bu yüzden ayrıca önemlidir. "Ev", "evlerimizden", "evlerimizdekilerden" gibi biçimler, İngilizce ağırlıklı eğitilmiş modellerde daha çok parçaya bölünür. Bu hem anlama kalitesini hem de token başına ödenen maliyeti etkileyebilir; ancak etkinin boyutu modelden modele değişir ve ancak kendi metinlerinizle ölçülür.
Neden önemli: Ağırlıkları indirilebilen bir model kendi sunucunuzda çalışabilir; lisansı ticari kullanıma izin vermiyorsa bu imkân ürününüzde işe yaramaz. "Açık kaynak" ifadesi tek başına ağırlıkların indirilebildiği anlamına gelmez.
Nasıl doğrularsınız: Model kartındaki lisans satırını okuyun (MIT, Apache 2.0 gibi). Kart lisans belirtmiyorsa ya da temel modelin lisansı farklıysa, ticari kullanım için yazılı teyit isteyin.
Neden önemli: Bir web arayüzünde denediğiniz model, API ile sunulmuyorsa ürününüze bağlanamaz. Kurumsal kurulumla sunulan bir platform ise satış süreci, sözleşme ve kurulum takvimi ister.
Nasıl doğrularsınız: Kurumun resmi sayfasında erişim yolunu arayın: "genel kullanıma açık", "başvuru", "indir", "API" ifadeleri. Beta ya da başvuru aşamasındaki bir modeli, takvimi bağlayıcı bir projenin tek dayanağı yapmayın.
Neden önemli: Genel amaçlı değerlendirme puanları, sizin belgelerinizdeki terimleri, müşterilerinizin yazım biçimini ve sektörünüzün mevzuat dilini ölçmez.
Nasıl doğrularsınız: Gerçek işinizden 50–100 soruluk bir test seti hazırlayın: sık sorulan müşteri soruları, uzun bir sözleşmeden özet, yazım hatalı kısa mesajlar, sayı ve tarih içeren cevaplar. Aynı seti aday modellere verin, cevapları iki kişi ayrı ayrı puanlasın. Kaynak gösterilmesi gereken işlerde modelin cevabını gerçekten verilen belgeye dayandırıp dayandırmadığına bakın.
Neden önemli: Kişisel veri içeren metinler yurt dışındaki bir sunucuda işleniyorsa KVKK'nın yurt dışına aktarım hükümleri devreye girer. Kamu, sağlık ve finans projelerinde verinin kurum dışına hiç çıkmaması şart olabilir.
Nasıl doğrularsınız: Sağlayıcıya verinin hangi ülkede işlendiğini, kaydedilip kaydedilmediğini ve model eğitiminde kullanılıp kullanılmadığını yazılı olarak sorun. Kapalı ağda çalışma şartınız varsa ya indirilebilir ağırlık ya da yerinde (on-premise) kurulum seçeneği arayın.
Neden önemli: Canlı bir iş sürecinde model tek başına yetmez: rol bazlı yetkilendirme, kayıt (log), hız sınırı, sürüm sabitleme ve kesinti durumunda ne olacağı sorulur.
Nasıl doğrularsınız: Sürüm değişikliklerinin nasıl duyurulduğunu, eski sürümün ne kadar süre açık kaldığını ve destek kanalını sorun. Araştırma amaçlı yayımlanmış bir modelde bu başlıkların sorumluluğu size geçer.
Neden önemli: API ile kullanılan modelde maliyet token başınadır ve kullanım arttıkça büyür. İndirilebilir modelde lisans ücretsiz olabilir ama sunucu, GPU ve bakım maliyeti size aittir.
Nasıl doğrularsınız: Aylık tahmini istek sayısını ve ortalama metin uzunluğunu çıkarın; her aday için iki senaryoyu (API ve kendi sunucunuz) yan yana hesaplayın.
Tablodaki her bilgi, geliştiren kurumun kendi sayfasından ya da Hugging Face'teki resmi hesabından alınmıştır (Eylül 2026). Performans puanı yazılmamıştır.
| Model / platform | Geliştiren | Kategori | Erişim | Lisans |
|---|---|---|---|---|
| BERTurk | MDZ Dijital Kütüphane ekibi (Bavyera Devlet Kütüphanesi), Türk NLP topluluğunun katkısıyla | Metin anlama modeli (BERT) | Hugging Face'ten indirilir | MIT |
| BİLGE | TÜBİTAK BİLGEM | Büyük dil modeli ailesi | Henüz genel kullanıma açık değil; kurumsal iletişim | Sayfada belirtilmemiş |
| HAVELSAN MAIN | HAVELSAN | Kurumsal yapay zeka platformu | Kurumsal kurulum, yerel sunucu | Ticari ürün |
| T3 AI | T3 Vakfı öncülüğünde; TÜBA duyurusuna göre T3 Vakfı ve Baykar iş birliği | Büyük dil modeli projesi | TEKNOFEST Sosyal'de beta | Açık kaynaklı proje olarak tanımlanıyor |
| Turkcell-LLM-7b-v1 | Turkcell | İnce ayarlı dil modeli (Mistral 7B tabanlı) | Hugging Face'ten indirilir | Apache 2.0 |
| TurkEmbed4STS | NewMind AI | İnce ayarlı embedding modeli | Hugging Face'ten indirilir | Model kartında belirtilmemiş |
| TurkishBERTweet | VRL Lab, Sabancı Üniversitesi | Sosyal medya metin modeli | Hugging Face'ten indirilir | MIT |
Aşağıdaki modeller alfabetik sıradadır; sıralama ya da puan değildir. Bilgiler geliştiren kurumların kendi sitelerinden ve Hugging Face'teki resmi hesaplarından alınmıştır (Eylül 2026).
Model kartına göre Bavyera Devlet Kütüphanesi'nin MDZ Dijital Kütüphane ekibi (dbmdz) tarafından Türkçe için açık kaynak olarak yayımlanan bir BERT modeli; ön eğitim verisinin bir kısmı ve modelin adı Türk NLP topluluğundan geliyor. Metin üretmez, sınıflandırma ve metin anlama görevleri için kullanılır; MIT lisansıyla indirilebilir.
BİLGE'nin resmi sitesine göre TÜBİTAK BİLGEM tarafından geliştirilen, Türkçenin yapısını ve kültürel birikimi temel alan bir büyük dil modeli ailesi; aile 1 milyardan 122 milyar parametreye uzanıyor, 122B sürümü geliştirilme aşamasında. Sitede henüz genel kullanıma açılmadığı yazıyor; kurumlar resmi kanallardan iletişime geçebiliyor.
HAVELSAN'ın ürün sayfasına göre kurumların kendi verileriyle eğitilebilen, kapalı veri ağında ya da internet ağında çalışabilen kurumsal yapay zeka platformu; yerel sunucularda kurulur ve çekirdeğinde 9 milyar parametreli bir Türkçe dil modeli bulunuyor. Son kullanıcıya açık bir sohbet uygulaması değil, kurumlara sunulan bir üründür.
T3 Vakfı'nın proje sayfasına göre T3 Vakfı öncülüğünde ve paydaşların iş birliğiyle yürütülen, açık kaynaklı bir büyük dil modeli projesi. TÜBA'nın duyurusuna göre T3 Vakfı ve Baykar iş birliğiyle geliştirilen model, Temmuz 2025'te TEKNOFEST Sosyal platformunda beta olarak kullanıma açıldı; kullanıcılar modeli etiketleyerek soru soruyor.
Turkcell'in Hugging Face'teki doğrulanmış kurum hesabında yayımlanan, Mistral 7B tabanlı Türkçe dil modeli; model kartına göre 5 milyar token temizlenmiş Türkçe ham veri ve Türkçe talimat setleriyle eğitildi. Apache 2.0 lisansıyla indirilebilir.
İstanbul'daki NewMind AI'nin Hugging Face hesabında yayımladığı Türkçe embedding modeli; model kartına göre cümle ve paragrafları 768 boyutlu vektörlere çevirir ve anlamsal arama, benzerlik ve kümeleme için kullanılır. Alibaba-NLP/gte-multilingual-base üzerine ince ayar yapılmıştır; kartta lisans belirtilmemiştir.
Sabancı Üniversitesi'ndeki VRL Lab'in yayımladığı, Türkçe sosyal medya metinleri için eğitilmiş dil modeli; model kartına göre 894 milyon Türkçe tweet ile eğitildi. MIT lisansıyla indirilebilir.
| İhtiyaç | Bakılacak model tipi | Dikkat edilecek nokta |
|---|---|---|
| Türkçe sohbet asistanı, özetleme | Büyük dil modeli (API ya da indirilebilir) | Kendi test setinizde Türkçe cevap kalitesi |
| Şirket belgelerinde arama ve kaynaklı cevap (RAG) | Embedding modeli + büyük dil modeli | Embedding modelinin kendi belge türünüzde isabeti |
| Yorum, şikâyet, e-posta sınıflandırma | Küçük, göreve özel metin anlama modeli (BERT tipi) | Etiketli örnek veri; büyük model çoğu zaman gerekmez |
| Sosyal medya analizi | Sosyal medya diliyle eğitilmiş model | Kısaltma, emoji ve yazım hatası içeren örneklerle test |
| Verinin kurum dışına çıkmaması | İndirilebilir ağırlık ya da yerinde kurulum | Lisans ve sunucu maliyeti |
| Süreç yürüten asistan (kayıt açma, bildirim, teklif) | AI ajanı ya da özel entegrasyon | Yetki sınırı, insan onayı, işlem kaydı |
Tek bir model çoğu projede yetmez. Bir kurum sohbet için bir büyük dil modeli, belge araması için bir embedding modeli ve sınıflandırma için küçük bir model kullanabilir. Yerli ve global modellerin birlikte kullanıldığı hibrit mimariler de yaygındır: kişisel veri içeren adımlar kurum içinde, genel bilgi gerektiren adımlar API üzerinden yürür.
Yapay zeka projelerinde sabit bir fiyat söylemek zordur; model seçimi, veri hacmi ve kullanım yoğunluğu maliyeti doğrudan değiştirir. Aşağıdaki süreler Atalay Tech'in yapay zekâ entegrasyonu sayfasındaki aralıklardır; kapsam netleştikten sonra tekliflendirilir. Kendi sürelerimizi açık yazıyoruz; başka firmalardan teklif alırken aynı kapsam kalemlerini karşılaştırın.
| Kapsam | Süre |
|---|---|
| Pilot sohbet asistanı | 2–6 hafta |
| Kurumsal RAG (belge arama ve kaynaklı cevap) | 1–3 ay |
| Çoklu modül AI platformu | 3–6 ay |
| Özel ML / görüntü işleme | Kapsama bağlı (veri seti ve GPU maliyeti ayrı) |
Bütçeyi iki ayrı kalem olarak planlayın:
İkisini ayrı sormayan bir teklif, canlıya çıktıktan sonra sürpriz üretir. Hizmet firması seçiyorsanız yapay zeka entegrasyon firması seçme rehberi aynı soruları firma tarafından ele alıyor.
Yerli yapay zeka modelleri tek bir listede yarışan ürünler değil; temel model, ince ayarlı model ve ürün ya da ajan olarak farklı ihtiyaçlara cevap veriyor. Seçimden önce kategoriyi ayırın, lisansı ve erişim yolunu kurumun kendi kaynağından doğrulayın. Türkçe performansı genel puanlarla değil kendi test setinizle ölçün. Verinin nerede işlendiğini yazılı olarak öğrenin ve geliştirme bütçesini aylık işletme maliyetinden ayrı planlayın.
Bu rehberi hazırlayan: Atalay Tech
Atalay Tech, Atalay Yazılım Ltd. Şti.'nin markasıdır; 2020'de İstanbul'da kuruldu, ofisi Şişli'de. React Native, Laravel ve Next.js ile mobil uygulama, web yazılımı ve yapay zeka entegrasyonu geliştiriyor. Geliştirdiği atalay.ai bir dil modeli değil; Türkiye'deki işletmelerin aylık ücretle yapay zekâ çalışanı işe aldığı bir platform. Bugün telefonla ücretsiz kayıt ve sohbet açık, çalışanlar yakında açılıyor.
atalay.ai proje sayfası · Yapay zekâ entegrasyonu · Referanslar
Bu rehber yapay zekâ yardımıyla hazırlandı, Atalay Tech tarafından kontrol edildi.
Türkiye'deki kurumlar, şirketler ya da üniversiteler tarafından geliştirilen ya da Türkçe için eğitilen yapay zeka modelidir. Sıfırdan eğitilmiş bir temel model olabileceği gibi, var olan bir modelin Türkçe veriyle ince ayarlanmış hâli de olabilir. Hangisine baktığınızı model kartındaki "temel model" bilgisinden anlarsınız.
Tek bir en iyi model yok; cevap kullanım amacına göre değişir. Sohbet asistanı, belge araması, metin sınıflandırma ve kapalı ağda çalışma ayrı model tipleri ister. Önce kategoriyi ayırın, ardından lisans, erişim yolu, veri yerleşimi ve kendi Türkçe test setinizdeki sonuçlarla karşılaştırın.
Büyük dil modeli metin anlar ve üretir. AI ajanı ise bir modeli kullanarak iş yapar: bilgi toplar, başka sistemlerde kayıt açar, bildirim gönderir. Ajanı değerlendirirken hangi sistemlere yazabildiğine, insan onayı isteyip istemediğine ve işlemlerini nereye kaydettiğine bakın.
Gerçek işinizden 50–100 soruluk bir set hazırlayın: müşteri soruları, belge özetleri, yazım hatalı kısa mesajlar, sayı ve tarih içeren cevaplar. Aynı seti aday modellere verin ve cevapları iki kişi ayrı ayrı puanlasın. Genel puan tabloları sizin terimlerinizi ve belgelerinizi ölçmez.
Modelin yerli olması tek başına yeterli değildir; belirleyici olan verinin nerede işlendiği ve saklandığıdır. Yurt dışındaki bir sunucuda işlenen kişisel veri için KVKK'nın aktarım hükümleri devreye girer. Verinin kurum dışına çıkmaması gerekiyorsa indirilebilir ağırlıklı model ya da yerinde kurulum seçeneği arayın.
Bazı işlerde evet, bazılarında hayır. Genel bilgi ve çok dilli görevlerde global modeller, veri yerleşimi ya da kapalı ağ şartı olan işlerde indirilebilir ya da yerinde kurulan modeller daha uygun olabilir. Pek çok proje ikisini birlikte kullanan hibrit bir mimariyle kurulur.
Lisans ücretsiz olabilir ama sunucu, GPU, bakım ve güncelleme maliyeti size aittir. Düşük kullanımda API genellikle daha az iş çıkarır; yüksek ve düzenli kullanımda kendi sunucunuz hesaplı hâle gelebilir. İki senaryoyu kendi tahmini istek sayınızla yan yana hesaplayın.
Hayır. Model yalnız cevap üretir; canlı bir sistem için veri hazırlığı, güvenli bir arka uç, yetkilendirme, işlem kaydı, yönetim paneli, izleme ve bakım da gerekir. Bütçe planlarken geliştirme maliyetini aylık token ya da sunucu maliyetinden ayrı tutun.
atalay.ai, işletmelerin yapay zekâ çalışanlarını maaşa bağladığı platform. Ayşe, Mert, Elif, Emre ve Can'ın arkasında Amazon Bedrock üzerinde Claude çalışıyor; şirketimizin kendi operasyonunu da Claude Agent SDK ile yürütüyoruz.
Yapay zeka entegrasyonu başlatma kontrol listesi; hedef belirleme, veri hazırlığı, süreç seçimi, güvenlik, maliyet, teknik mimari, MVP planı ve bakım adımlarını tek çerçevede ele alır. Kurumsal ekipler için uygulanabilir, ölçülebilir ve riskleri azaltan bir başlangıç rehberi sunar.
Kurumsal şirketler için AI otomasyon, yalnızca chatbot kurmak değil; süreç analizi, veri güvenliği, API entegrasyonu, insan onayı, ölçümleme ve bakım disiplinidir. Bu rehber 2026'da AI otomasyon projesi planlayan şirketler için kapsam, maliyet, risk ve uygulama adımlarını pratik şekilde açıklar.
